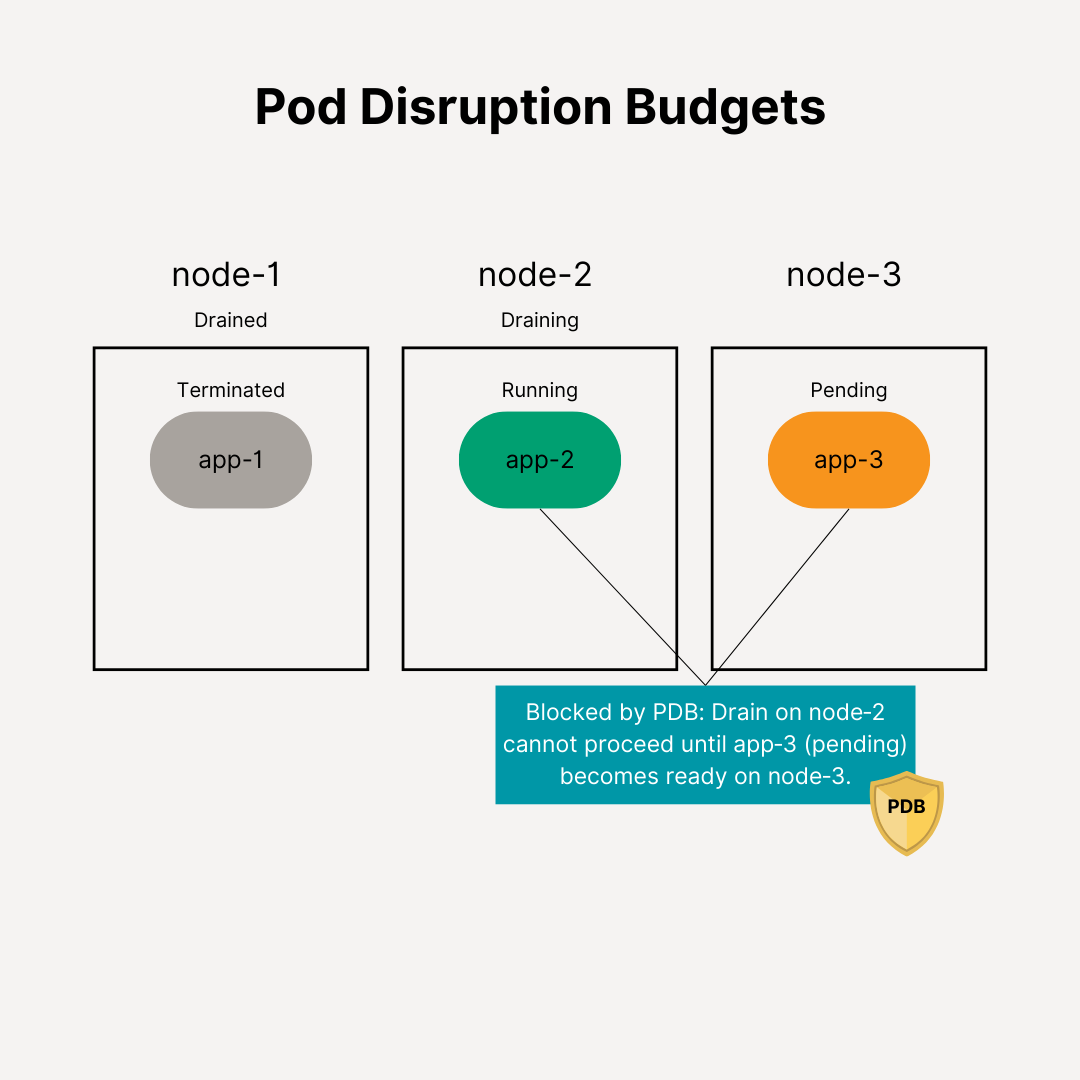
Menjaga aplikasi tetap tersedia bukan hanya soal menjalankan beberapa replika. Saat node Kubernetes perlu diperbarui, dikosongkan, atau diperkecil, beberapa Pod bisa dihentikan hampir bersamaan jika prosesnya tidak dikendalikan. Akibatnya, layanan yang sebenarnya memiliki replika dapat kehilangan kapasitas atau bahkan berhenti melayani permintaan. Pod Disruption Budget (PDB) membantu membatasi gangguan sukarela tersebut dengan menentukan berapa banyak Pod yang boleh tidak tersedia pada satu waktu.
PDB berguna bagi tim yang mengelola aplikasi produksi, terutama ketika pemeliharaan cluster dilakukan rutin. Namun, fitur ini bukan jaminan bahwa aplikasi selalu hidup. PDB perlu dipadukan dengan replika yang cukup, pemeriksaan kesiapan aplikasi, distribusi Pod antarnode, serta prosedur pemulihan yang teruji.
Apa itu Pod Disruption Budget?
Pod Disruption Budget adalah objek Kubernetes yang menetapkan batas gangguan terhadap sekumpulan Pod yang dipilih melalui label selector. Secara umum, PDB mengatur gangguan sukarela, misalnya ketika administrator menjalankan kubectl drain untuk memelihara node. Kubernetes menggunakan aturan itu untuk menentukan apakah sebuah permintaan pengusiran Pod boleh dilanjutkan atau harus menunggu sampai kapasitas sehat kembali mencukupi.
PDB berbeda dari strategi rolling update pada Deployment atau StatefulSet. PDB terutama melindungi proses pengusiran melalui Eviction API, sedangkan pengaturan seperti maxUnavailable dan maxSurge pada Deployment mengendalikan pergantian replika selama pembaruan aplikasi. Keduanya saling melengkapi, bukan saling menggantikan.
Gangguan sukarela dan gangguan tak terhindarkan
Contoh gangguan sukarela meliputi pengosongan node untuk upgrade, pengurangan kapasitas cluster, atau pemeliharaan yang dimulai administrator. Dalam situasi ini, PDB dapat menolak sementara pengusiran jika jumlah Pod sehat akan turun di bawah batas yang ditetapkan.
Gangguan tak terhindarkan mencakup kerusakan perangkat keras, node kehilangan konektivitas, atau Pod dihentikan akibat tekanan sumber daya. PDB tidak dapat mencegah kejadian tersebut, walaupun Pod yang terdampak tetap memengaruhi perhitungan ketersediaan. Karena itu, aplikasi penting sebaiknya memiliki replika yang tersebar pada beberapa node atau zona, bukan sekadar mengandalkan satu PDB.
Memilih minAvailable atau maxUnavailable
Konfigurasi PDB menyediakan dua pendekatan yang saling eksklusif. minAvailable menetapkan jumlah atau persentase minimum Pod yang harus tetap tersedia. Sebaliknya, maxUnavailable menetapkan jumlah atau persentase maksimum Pod yang boleh tidak tersedia akibat gangguan yang dicakup PDB.
Misalnya, aplikasi web memiliki tiga replika. Menetapkan minAvailable: 2 berarti setidaknya dua Pod harus tetap tersedia ketika Kubernetes mempertimbangkan pengusiran sukarela. Alternatifnya, maxUnavailable: 1 menyatakan bahwa paling banyak satu Pod boleh tidak tersedia dalam kondisi tersebut. Pilih satu pendekatan yang paling mudah dipahami dan sesuai dengan kebutuhan layanan.
Hindari menetapkan batas terlalu ketat tanpa mempertimbangkan kapasitas cluster. PDB yang menuntut semua Pod selalu tersedia dapat membuat operasi drain tertahan ketika tidak ada ruang untuk mengusir satu Pod pun. Sebaliknya, anggaran yang terlalu longgar bisa mengizinkan gangguan serentak yang mengurangi kapasitas layanan secara signifikan.
Contoh konfigurasi PDB
Berikut contoh sederhana untuk aplikasi yang Pod-nya memiliki label app: katalog. Pastikan label pada selector benar-benar cocok dengan label Pod yang dikelola Deployment.
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: katalog-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: katalog
Simpan konfigurasi sebagai katalog-pdb.yaml, lalu terapkan dengan kubectl apply -f katalog-pdb.yaml. Periksa hasilnya melalui kubectl get pdb dan kubectl describe pdb katalog-pdb. Perhatikan nilai Pod sehat saat ini, jumlah minimum yang diinginkan, serta jumlah gangguan yang diizinkan. Jangan menganggap objek berhasil hanya karena perintah apply tidak menampilkan error.
Langkah penerapan yang lebih aman
- Pastikan replika memadai. PDB tidak menciptakan Pod tambahan. Jika hanya ada satu replika, anggaran yang meminta satu Pod tetap tersedia akan mencegah pengusiran sukarela, tetapi tidak menyelesaikan kebutuhan redundansi.
- Selaraskan label selector. Selector yang salah dapat membuat PDB tidak melindungi workload yang dimaksud. Cocokkan selector dengan label aktual pada Pod, bukan hanya nama Deployment.
- Uji proses pemeliharaan. Di lingkungan staging, lakukan drain pada node dan amati apakah pengusiran berjalan sesuai ekspektasi. Siapkan timeout dan prosedur pembatalan jika operasi tertahan.
- Periksa kondisi Pod yang tidak sehat. Pod yang terus gagal readiness bisa membuat drain menunggu. Kubernetes menyediakan kebijakan
unhealthyPodEvictionPolicy; pilihanAlwaysAllowdapat membantu pengusiran Pod tidak sehat ketika node perlu dikosongkan, tetapi keputusan ini harus disesuaikan dengan risiko aplikasi. - Ukur dampak pada layanan. Pantau error rate, latensi, jumlah replika siap, serta kapasitas node selama pemeliharaan. Anggaran yang valid secara teknis belum tentu cukup untuk memenuhi target layanan.
Kesalahan yang sering terjadi
Kesalahan umum adalah menganggap PDB mencegah semua Pod dihapus. Penghapusan langsung Pod atau Deployment dapat melewati pemeriksaan anggaran, dan PDB tidak menghalangi kegagalan node yang tidak disengaja. Kesalahan lain ialah menggunakan selector yang tidak cocok, menetapkan minimum sama dengan seluruh replika tanpa rencana kapasitas tambahan, atau tidak memantau status PDB sebelum upgrade cluster.
Jika kubectl drain tertahan, jangan langsung menghapus Pod secara paksa. Periksa status PDB, kesiapan replika, event, serta apakah node lain memiliki kapasitas untuk menjadwalkan ulang Pod. Memaksa penghapusan mungkin mempercepat pemeliharaan, tetapi juga dapat menghilangkan perlindungan ketersediaan yang sengaja dibuat.
Kesimpulan
Pod Disruption Budget membantu menjaga kapasitas aplikasi selama pemeliharaan Kubernetes dengan membatasi gangguan sukarela. Tentukan batas berdasarkan kebutuhan layanan, validasi selector, pastikan replika tersebar dengan baik, dan uji proses drain sebelum diterapkan di produksi. Gunakan PDB sebagai satu lapisan dalam strategi ketersediaan—bersama readiness probe, replika yang cukup, pemantauan, serta rencana pemulihan—bukan sebagai pengganti semuanya.
Referensi resmi: Dokumentasi Kubernetes: Disruptions dan Pod Disruption Budget dan Referensi API PodDisruptionBudget.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba