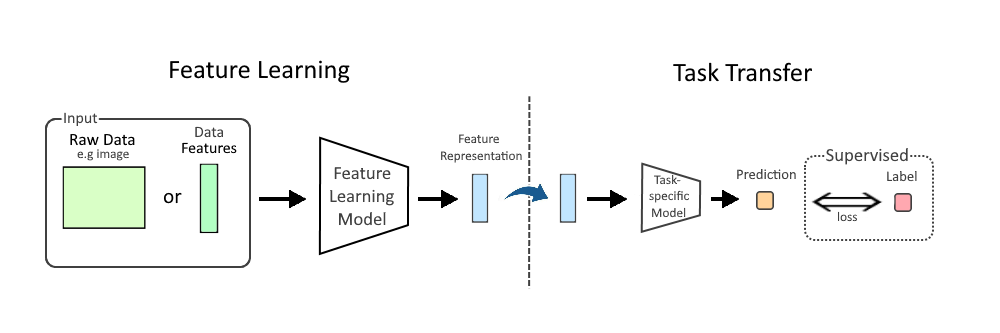
Model machine learning tidak hanya bergantung pada algoritma. Kualitas dan konsistensi data yang masuk ke model sama pentingnya. Tim sering menghitung fitur—misalnya jumlah transaksi, rata-rata belanja, atau aktivitas pengguna—di beberapa tempat berbeda. Akibatnya, nilai yang dipakai saat pelatihan bisa berbeda dari nilai ketika model melayani permintaan nyata. Feature store membantu mengelola fitur tersebut secara terpusat agar definisi, riwayat, dan cara penggunaannya lebih konsisten.
Feature store bukan syarat bagi setiap proyek AI. Namun, ketika jumlah model, sumber data, dan tim bertambah, pendekatan ini dapat mengurangi pekerjaan berulang serta mempermudah pemantauan kualitas data.
Apa itu feature store?
Feature store adalah lapisan pengelolaan yang menyimpan, mendokumentasikan, dan menyajikan fitur yang sudah diproses untuk kebutuhan machine learning. Fitur merupakan representasi data yang digunakan model untuk membuat prediksi. Contohnya meliputi jumlah pembelian dalam 30 hari, rata-rata nilai transaksi, frekuensi login, atau usia akun.
Alih-alih setiap tim membuat perhitungan sendiri, definisi fitur dapat dipakai ulang oleh beberapa model. Sebuah katalog juga dapat mencatat pemilik fitur, sumber data, rumus, jadwal pembaruan, serta batasan penggunaannya. Feature store bukan pengganti data warehouse atau data lake; sistem ini berfokus pada penyajian fitur yang siap digunakan model.
Mengapa konsistensi fitur penting?
Masalah yang umum disebut training-serving skew terjadi ketika data atau perhitungan yang digunakan saat pelatihan berbeda dari kondisi saat model berjalan. Misalnya, model dilatih menggunakan total transaksi yang dihitung berdasarkan waktu UTC, tetapi layanan prediksi menghitungnya berdasarkan zona waktu lokal. Perbedaan kecil itu bisa menghasilkan nilai yang tidak sebanding.
Feature store membantu mengurangi ketidaksesuaian dengan menyimpan definisi fitur yang sama dan membuat proses pembaruannya dapat ditelusuri. Penggunaan ulang juga mengurangi duplikasi kode, memudahkan audit, serta mempercepat eksperimen karena tim tidak harus membangun ulang setiap fitur dari awal. Meski demikian, feature store tidak otomatis menjamin data benar; validasi dan pemantauan tetap diperlukan.
Offline store dan online store
Banyak implementasi memisahkan penyimpanan fitur menjadi dua jalur. Offline store menyimpan data historis dalam jumlah besar untuk pelatihan, analisis, dan evaluasi. Penyimpanan ini biasanya dioptimalkan untuk pemrosesan batch dan penelusuran data berdasarkan waktu.
Online store menyediakan nilai fitur terbaru dengan latensi rendah untuk prediksi saat aplikasi berjalan. Contohnya, sistem deteksi penipuan mungkin membutuhkan ringkasan aktivitas akun terbaru dalam hitungan milidetik. Tidak semua proyek memerlukan kedua jalur: model yang dijalankan secara batch mungkin cukup memakai penyimpanan offline.
Hal penting saat merancang keduanya adalah memastikan fitur memiliki definisi dan aturan waktu yang selaras. Perhatikan juga kebijakan kedaluwarsa data, perilaku ketika nilai belum tersedia, dan apa yang harus dilakukan layanan ketika online store tidak dapat diakses.
Alur kerja menerapkan feature store
- Tentukan kebutuhan model. Catat fitur yang benar-benar diperlukan, sumber datanya, frekuensi pembaruan, dan target latensi. Mulailah dari satu kasus penggunaan yang jelas.
- Definisikan fitur sebagai kontrak. Dokumentasikan nama, tipe data, satuan, rentang yang masuk akal, rumus, pemilik, serta waktu acuan. Hindari nama yang sama untuk perhitungan berbeda.
- Bangun pipeline yang dapat diulang. Terapkan transformasi melalui kode terkontrol dan versi yang tercatat. Gunakan pengujian untuk mendeteksi nilai kosong, duplikasi, perubahan skema, atau data yang datang terlambat.
- Isi penyimpanan historis dan online sesuai kebutuhan. Untuk fitur berbasis waktu, pastikan pelatihan hanya memakai informasi yang memang tersedia pada saat prediksi seharusnya dibuat. Ini mencegah kebocoran data dari masa depan.
- Ukur hasil di produksi. Pantau keterlambatan pembaruan, tingkat nilai hilang, distribusi fitur, latensi pembacaan, dan perbedaan antara data pelatihan serta layanan. Tetapkan peringatan dan prosedur pemulihan.
Praktik desain yang perlu dijaga
Gunakan satu definisi yang menjadi rujukan, tetapi jangan menganggap setiap fitur harus dibagikan ke semua model. Fitur yang spesifik untuk satu kasus dapat tetap terpisah agar tidak menimbulkan ketergantungan yang tidak perlu. Beri versi pada definisi yang berubah secara signifikan, lalu dokumentasikan dampaknya terhadap model yang menggunakannya.
Tetapkan pula tanggung jawab yang jelas. Pemilik fitur perlu mengetahui sumber data, konsumen yang bergantung padanya, dan proses untuk menghentikan fitur yang tidak lagi aman atau akurat. Sebelum mengubah skema atau rumus, uji kompatibilitas dan siapkan masa transisi bila layanan lama masih menggunakannya.
Keamanan dan privasi data
Fitur dapat mengandung informasi sensitif meskipun bentuknya sudah berupa angka atau ringkasan. Terapkan akses berdasarkan kebutuhan, enkripsi saat penyimpanan dan pengiriman, pencatatan akses, serta masa retensi yang sesuai. Hindari memasukkan identitas langsung ke fitur bila tidak diperlukan, dan pastikan data tidak digunakan di luar tujuan yang diizinkan.
Prinsip ini sejalan dengan pendekatan minimisasi data. Jika fitur berasal dari interaksi pengguna dengan sistem AI, tinjau juga panduan menjaga privasi saat menggunakan AI. Hak akses dan proses penghapusan harus mencakup salinan historis maupun cache yang relevan.
Kapan feature store layak digunakan?
Pertimbangkan feature store ketika beberapa model menggunakan fitur serupa, perhitungan yang sama terus dibuat ulang, prediksi membutuhkan data terbaru dengan latensi rendah, atau tim kesulitan melacak asal-usul fitur. Untuk eksperimen kecil dengan satu model dan pipeline sederhana, tabel terkelola serta kode transformasi yang rapi mungkin sudah cukup.
Hindari membangun infrastruktur besar hanya karena sedang populer. Nilai manfaatnya berdasarkan biaya operasional, kompleksitas integrasi, kebutuhan ketersediaan, dan kemampuan tim untuk merawatnya. Implementasi yang baik adalah yang menyelesaikan masalah nyata tanpa menambah komponen yang tidak diperlukan.
Kesimpulan
Feature store membantu tim mengelola fitur machine learning secara konsisten, dapat digunakan ulang, dan lebih mudah diaudit. Mulailah dengan mendefinisikan fitur dan kebutuhan model, lalu bangun pipeline yang teruji, pilih penyimpanan sesuai pola penggunaan, serta pantau kualitasnya setelah model berjalan. Konsistensi bukan hanya urusan penyimpanan: definisi yang jelas, tata kelola, pengujian, dan keamanan data sama pentingnya untuk menjaga prediksi tetap dapat dipercaya.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba