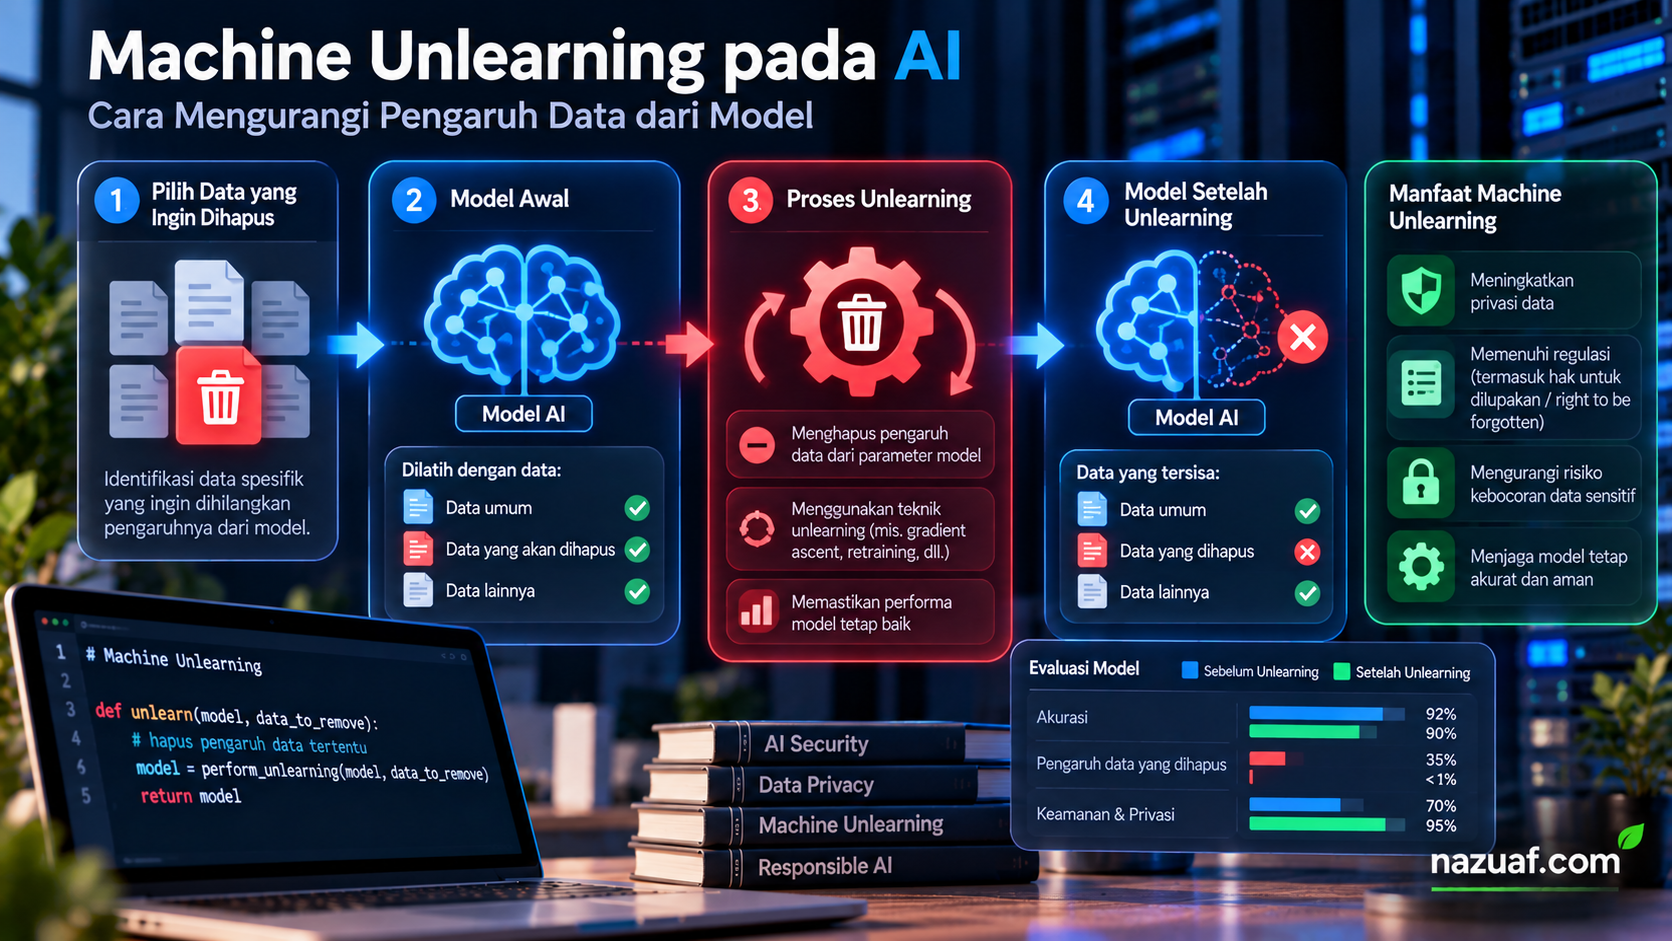
Model kecerdasan buatan belajar dari contoh yang dikumpulkan selama pelatihan. Namun, bagaimana jika sebagian data ternyata berisi informasi pribadi, digunakan tanpa izin yang sesuai, atau perlu ditarik kembali? Menghapus berkas dari folder dataset saja belum tentu menghilangkan pengaruhnya dari model yang sudah dilatih.
Di sinilah machine unlearning menjadi penting. Teknik ini berupaya mengurangi atau menghapus kontribusi data tertentu dari model tanpa selalu mengulang seluruh proses pelatihan dari awal. Pendekatan ini menjanjikan efisiensi, tetapi hasilnya perlu diuji dengan cermat agar proses “melupakan” tidak sekadar menjadi klaim.
Apa Itu Machine Unlearning?
Machine unlearning adalah kumpulan metode untuk membuat model tidak lagi mempertahankan pengaruh dari contoh pelatihan tertentu. Permintaannya bisa berasal dari pengguna yang menarik persetujuan, organisasi yang menemukan data bermasalah, atau tim pengembang yang harus memperbaiki dataset.
Tujuannya bukan sekadar menghapus data mentah. Selama pelatihan, model mengubah parameter internal berdasarkan pola dalam data. Unlearning mencoba mengubah keadaan model sehingga perilakunya mendekati model yang dilatih tanpa data yang diminta untuk dihapus.
Istilah “mendekati” penting karena tidak semua metode memberikan jaminan matematis yang sama. Sebagian pendekatan mengejar penghapusan yang kuat dengan biaya komputasi besar, sementara metode lain memakai perkiraan agar lebih cepat.
Mengapa Penghapusan Data Saja Tidak Cukup?
Bayangkan sebuah dataset berisi ribuan contoh, lalu satu catatan pribadi dihapus dari penyimpanan. Jika model sebelumnya sudah dilatih menggunakan catatan itu, parameter model tidak otomatis kembali ke keadaan semula. Model mungkin masih mengingat pola atau dapat mengungkap sebagian informasi melalui keluaran tertentu.
Risiko ini berbeda menurut jenis sistem. Model klasifikasi bisa mempelajari pengaruh satu contoh pada batas keputusan. Model bahasa besar dapat menyimpan asosiasi dari data pelatihan, meskipun tidak berarti setiap informasi yang pernah dilihatnya bisa dimunculkan kembali. Karena itu, penghapusan harus dirancang berdasarkan ancaman dan cara model digunakan.
Pendekatan yang Umum Digunakan
- Pelatihan ulang dari awal. Model dilatih kembali menggunakan dataset yang sudah dibersihkan. Ini dapat menjadi pembanding yang kuat, tetapi mahal untuk model besar dan proses yang sering diulang.
- Unlearning berbasis pembaruan parameter. Algoritma menyesuaikan bagian tertentu dari model untuk mengurangi pengaruh data sasaran. Biayanya bisa lebih rendah, tetapi kualitas hasil bergantung pada metode dan struktur model.
- Pembagian model atau data sejak awal. Sistem dilatih dalam beberapa bagian agar penghapusan di kemudian hari hanya membutuhkan pelatihan ulang pada bagian yang terdampak. Strategi ini perlu dipikirkan sejak desain, bukan selalu mudah ditambahkan belakangan.
- Penghapusan pada lapisan pendukung. Untuk aplikasi berbasis retrieval, cache, atau basis data vektor, menghapus dokumen dari indeks dan membangun ulang indeks dapat menghilangkan sumber yang bisa diambil sistem. Namun, langkah ini tidak sama dengan menghapus pengaruh data yang sudah masuk ke bobot model.
Alur Praktis Menerapkan Unlearning
- Temukan seluruh salinan data. Catat dataset utama, hasil prapemrosesan, cache, indeks pencarian, snapshot, dan cadangan yang relevan. Penghapusan tidak lengkap jika hanya dilakukan pada satu lokasi.
- Telusuri asal-usul model. Simpan informasi versi dataset, eksperimen, checkpoint, dan model turunan. Tanpa jejak ini, tim sulit mengetahui model mana yang terpengaruh.
- Tentukan cakupan permintaan. Pastikan identitas data sasaran dan alasan penghapusannya jelas. Batasi akses ke data sensitif selama proses berlangsung.
- Pilih metode dan pembanding. Bandingkan hasil unlearning dengan model sebelum perubahan dan, jika memungkinkan, model acuan yang dilatih tanpa data sasaran. Catat biaya, waktu, dan dampak terhadap akurasi.
- Uji sebelum mengganti model aktif. Jalankan pengujian privasi, kualitas tugas, regresi, dan keamanan. Simpan hasilnya sebagai bukti bahwa perubahan memenuhi kriteria yang ditetapkan.
- Catat dan pantau hasilnya. Dokumentasikan model pengganti, data yang ditangani, batas metode, waktu pelaksanaan, serta proses pemulihan jika terjadi penurunan kualitas.
Bagaimana Memverifikasi Model Benar-Benar “Melupakan”?
Tidak ada satu pengujian yang cocok untuk semua kasus. Tim dapat memakai pengujian membership inference untuk menilai apakah seseorang masih bisa menebak bahwa sebuah contoh pernah menjadi data pelatihan. Pengujian keluaran juga dapat memeriksa apakah informasi sasaran masih mudah dipulihkan.
Di sisi lain, model harus tetap bekerja pada data yang tidak diminta untuk dihapus. Ukur akurasi, tingkat kesalahan, konsistensi jawaban, latensi, dan dampak pada kelompok data yang relevan. Jika model kehilangan terlalu banyak kemampuan umum, unlearning mungkin terlalu agresif. Hasil yang baik menyeimbangkan pengurangan pengaruh data sasaran dan pemeliharaan fungsi yang sah.
Pengujian tersebut memberikan bukti, bukan jaminan universal. Klaim yang kuat harus menjelaskan asumsi, jenis serangan yang diuji, batas evaluasi, dan apakah metode memberikan jaminan formal atau hanya pendekatan empiris.
Batasan dan Hal yang Perlu Diingat
Machine unlearning bukan tombol ajaib untuk semua kewajiban privasi. Model, log, dataset, indeks pencarian, cadangan, dan salinan yang sudah didistribusikan bisa memerlukan tindakan berbeda. Dalam layanan berbasis AI generatif, jawaban juga dapat dipengaruhi konteks percakapan atau sumber eksternal, bukan hanya bobot model.
Penghapusan data juga perlu dibedakan dari kepatuhan hukum. Kebutuhan dan pengecualian bergantung pada yurisdiksi, tujuan pemrosesan, serta dasar hukum yang berlaku. Tim sebaiknya bekerja sama dengan pengelola privasi dan hukum, bukan menganggap satu metode teknis otomatis menyelesaikan semua kewajiban.
Kesimpulan
Machine unlearning menawarkan cara untuk menangani data yang seharusnya tidak lagi memengaruhi model AI. Agar dapat dipercaya, penerapannya membutuhkan inventaris data, pelacakan versi, pemilihan metode yang sesuai, pengujian privasi, serta evaluasi kualitas sebelum model pengganti digunakan. Untuk banyak organisasi, langkah awal terbaik adalah merancang tata kelola data dan jejak pelatihan yang rapi sejak awal. Dengan begitu, permintaan penghapusan dapat ditangani secara terukur, bukan melalui perkiraan.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba