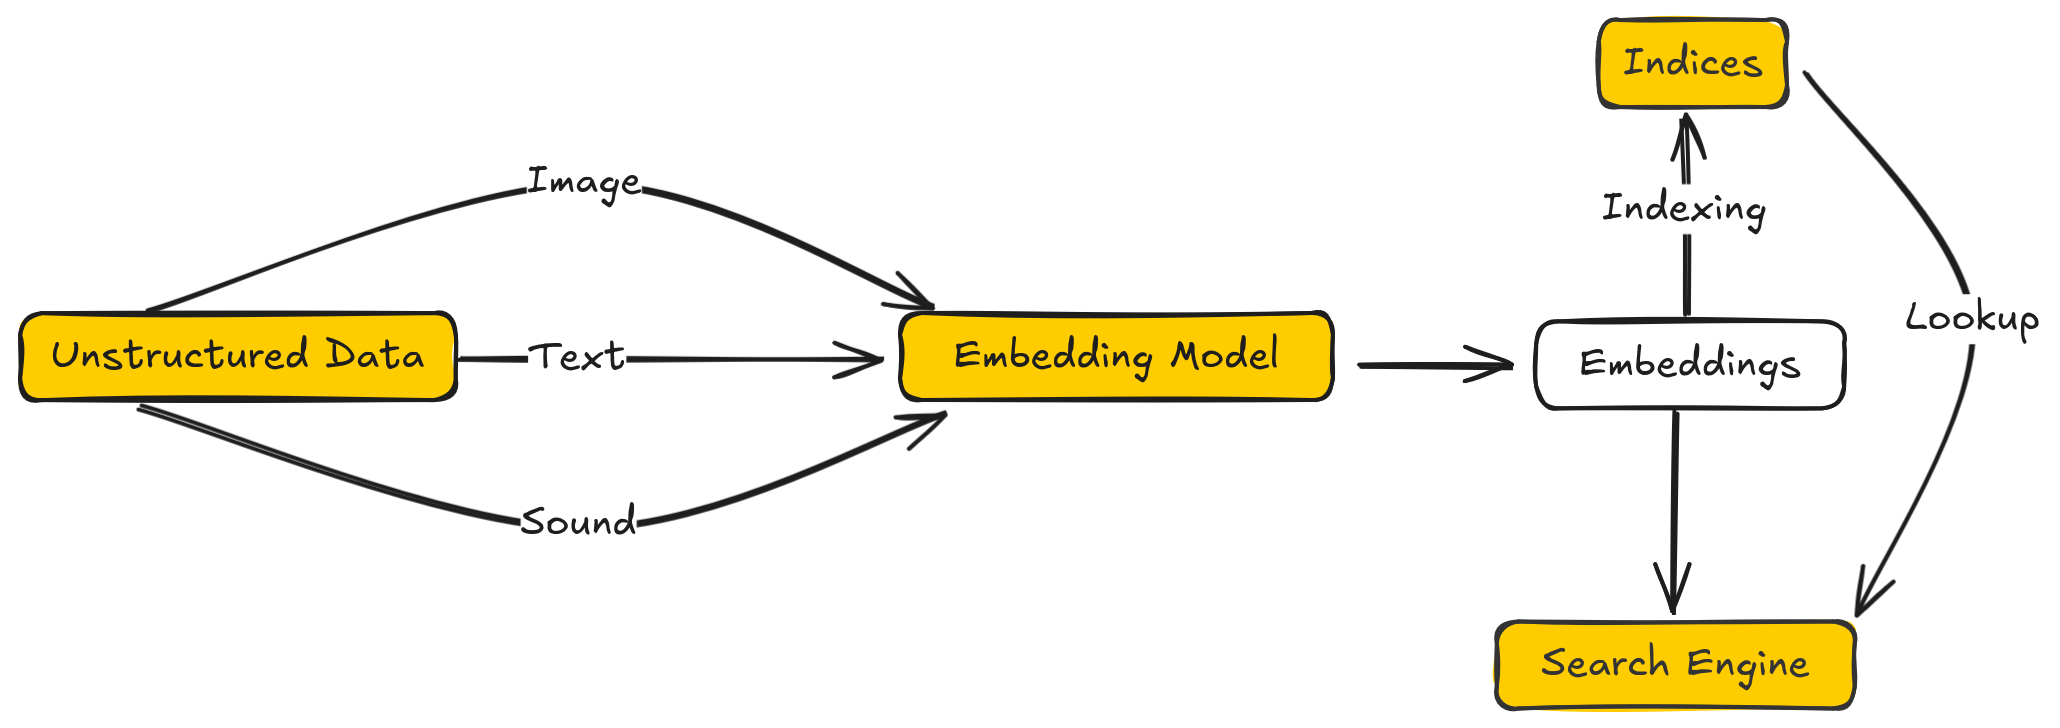
Ketika aplikasi AI harus menjawab pertanyaan berdasarkan banyak dokumen, pencarian kata kunci biasa kadang tidak cukup. Pengguna bisa menanyakan sesuatu dengan istilah yang berbeda dari teks sumber, tetapi maksudnya sama. Di sinilah vector database sering digunakan: teknologi penyimpanan dan pencarian yang membantu sistem menemukan informasi berdasarkan kemiripan makna, bukan hanya kecocokan kata.
Vector database bukan model AI dan tidak otomatis membuat jawaban menjadi benar. Teknologi ini merupakan salah satu komponen yang dapat membantu aplikasi menemukan konteks relevan untuk digunakan model bahasa. Memahami cara kerjanya penting agar implementasinya bermanfaat, efisien, dan tetap aman.
Apa itu vector database?
Vector database menyimpan representasi numerik yang disebut vektor, biasanya dihasilkan oleh model embedding. Sebuah paragraf, dokumen, gambar, atau potongan teks diubah menjadi deretan angka yang menangkap pola tertentu dari data tersebut. Dalam ruang vektor, item yang maknanya mirip diharapkan berada relatif berdekatan menurut ukuran kemiripan yang digunakan.
Misalnya, pertanyaan “bagaimana mengganti kata sandi akun?” dapat mendekati dokumen yang membahas “prosedur reset password”, meskipun frasa yang dipakai tidak sama. Hasil pencarian tetap bergantung pada kualitas model embedding, cara data dipotong, dan isi koleksi yang disimpan.
Bagaimana proses pencarian semantik bekerja?
- Siapkan sumber data. Kumpulkan dokumen yang memang boleh dipakai aplikasi, lalu bersihkan format, duplikasi, dan informasi yang tidak diperlukan.
- Bagi dokumen menjadi potongan. Teks panjang biasanya dipecah menjadi bagian yang lebih kecil agar hasil pencarian lebih terarah. Potongan terlalu pendek bisa kehilangan konteks, sedangkan potongan terlalu panjang dapat mengaburkan informasi penting.
- Buat embedding. Model embedding mengubah setiap potongan menjadi vektor. Model yang sama atau kompatibel perlu digunakan saat mengindeks dan saat membuat vektor dari pertanyaan.
- Simpan vektor dan metadata. Database menyimpan vektor bersama informasi seperti sumber, tanggal, kategori, atau izin akses. Metadata membantu hasil pencarian disaring sesuai kebutuhan.
- Cari kandidat yang mirip. Pertanyaan pengguna diubah menjadi vektor, lalu sistem mencari tetangga terdekat berdasarkan ukuran seperti cosine similarity atau jarak Euclidean, sesuai konfigurasi.
- Gunakan konteks yang ditemukan. Dalam pola retrieval-augmented generation (RAG), potongan terpilih diberikan kepada model generatif sebagai konteks untuk menyusun jawaban. Aplikasi tetap perlu memeriksa relevansi dan membatasi apa yang boleh diakses.
Kapan teknologi ini berguna?
Vector database dapat membantu pencarian dokumen internal, pusat bantuan pelanggan, katalog produk, pengelompokan konten, dan sistem tanya jawab berbasis dokumen. Teknologi ini sangat berguna ketika pengguna menyampaikan kebutuhan dengan bahasa alami atau sinonim yang tidak persis sama dengan sumber.
Namun, pencarian vektor bukan pengganti universal untuk pencarian teks. Nomor tiket, kode produk, alamat email, nama berkas, dan istilah yang harus cocok persis sering lebih cocok ditangani dengan pencarian leksikal. Banyak aplikasi menggabungkan pencarian kata kunci dan pencarian vektor, lalu mengurutkan ulang hasil dengan model reranking. Pendekatan hibrida dapat meningkatkan cakupan, tetapi perlu diuji menggunakan pertanyaan nyata dari pengguna.
Risiko dan kesalahan implementasi
Hasil terlihat mirip, tetapi salah konteks
Kedekatan vektor bukan bukti bahwa dua potongan benar-benar menjawab pertanyaan yang sama. Informasi usang, potongan tanpa konteks, atau dokumen yang hanya membahas istilah serupa dapat muncul di urutan atas. Ukur kualitas dengan kumpulan pertanyaan uji, tinjau hasil yang gagal, dan sediakan jawaban “tidak menemukan sumber yang cukup” ketika relevansi rendah.
Kebocoran data antar pengguna
Jika database berisi dokumen internal, pencarian harus menerapkan izin akses sebelum konteks diberikan kepada model. Jangan mengandalkan instruksi prompt saja untuk menjaga kerahasiaan. Terapkan filter metadata di sisi server, pisahkan koleksi bila dibutuhkan, dan uji apakah pengguna biasa dapat mengambil dokumen milik tim lain.
Prompt injection di dalam dokumen
Dokumen yang ditemukan dapat memuat instruksi berbahaya, misalnya teks yang mencoba menyuruh model mengabaikan aturan atau mengungkap rahasia. Perlakukan hasil retrieval sebagai data yang perlu dianalisis, bukan sebagai instruksi tepercaya. Risiko ini berkaitan dengan serangan prompt injection pada AI, terutama ketika sistem mengakses dokumen atau alat eksternal.
Biaya dan privasi embedding
Indeks besar memerlukan ruang penyimpanan, memori, dan sumber daya untuk membangun ulang indeks ketika model embedding berubah. Mengirim dokumen ke layanan embedding eksternal juga dapat menimbulkan kewajiban privasi atau kontraktual. Periksa kebijakan pemrosesan data, minimalkan informasi sensitif, dan evaluasi apakah embedding lokal lebih sesuai untuk kebutuhan tertentu.
Checklist sebelum diterapkan
- Tentukan jenis pertanyaan dan ukur kualitas pencarian dengan contoh yang mewakili penggunaan sebenarnya.
- Catat asal, pemilik, tanggal pembaruan, dan izin setiap dokumen yang diindeks.
- Terapkan autentikasi serta otorisasi pada tahap retrieval, bukan hanya pada antarmuka pengguna.
- Hapus atau perbarui embedding ketika dokumen sumber diubah, dihapus, atau izinnya dicabut.
- Uji pencarian hibrida dan reranking jika kecocokan kata kunci tetap penting.
- Jangan mengirim konteks yang tidak relevan atau terlalu banyak kepada model generatif.
- Catat metrik seperti relevansi hasil, latensi, biaya, dan kegagalan tanpa menyimpan data sensitif secara berlebihan.
Kesimpulan
Vector database membantu aplikasi AI menemukan informasi berdasarkan kemiripan semantik dan sering menjadi bagian dari arsitektur RAG. Hasil yang baik tidak hanya ditentukan oleh database, tetapi juga kualitas embedding, pemotongan dokumen, metadata, evaluasi, serta kontrol akses. Mulailah dari kebutuhan pencarian yang jelas, uji dengan data representatif, dan perlakukan setiap dokumen sebagai sumber yang harus memiliki izin serta asal-usul yang dapat diperiksa. Dengan begitu, pencarian semantik dapat menjadi komponen yang berguna tanpa mengorbankan keamanan dan keandalan aplikasi.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba