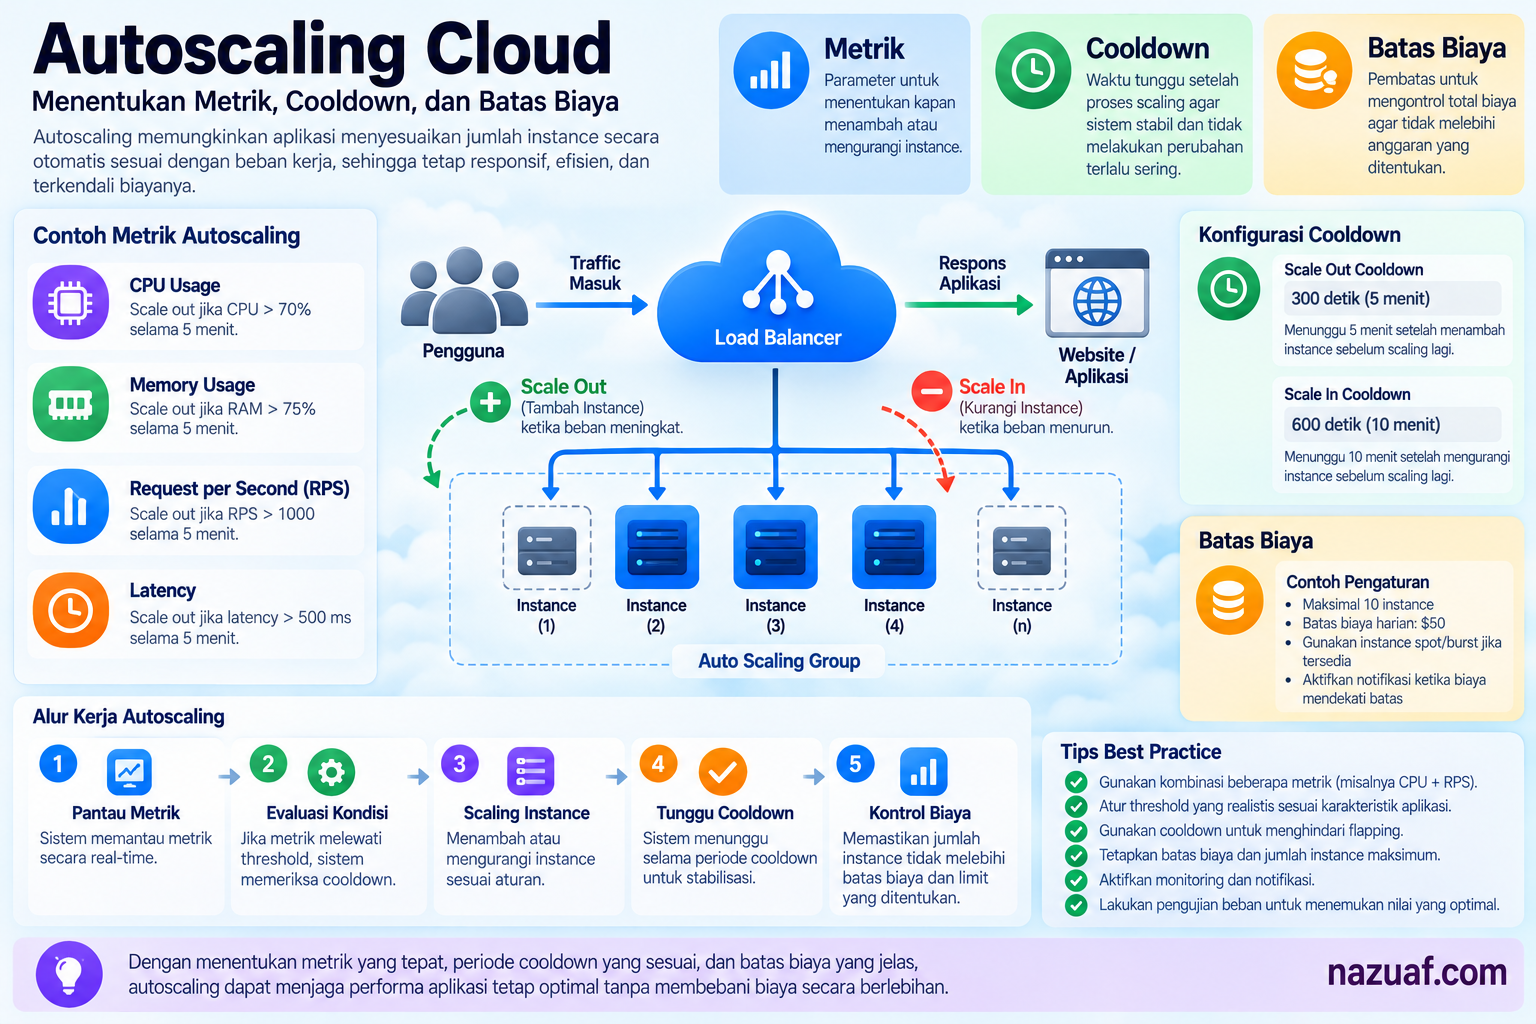
Autoscaling cloud adalah mekanisme untuk menyesuaikan jumlah instance atau kapasitas komputasi berdasarkan perubahan kebutuhan aplikasi. Ketika permintaan meningkat, sistem dapat menambah kapasitas agar layanan tetap responsif. Saat beban turun, kapasitas dapat dikurangi sehingga sumber daya yang tidak lagi diperlukan tidak terus menimbulkan biaya. Pendekatan ini membantu menjaga keseimbangan antara kinerja, ketersediaan, dan efisiensi biaya.
Namun, autoscaling bukan tombol otomatis yang selalu membuat aplikasi lebih cepat dan lebih murah. Hasilnya sangat dipengaruhi oleh metrik yang dipantau, waktu yang dibutuhkan instance untuk siap, batas kapasitas, kebijakan scale-out dan scale-in, serta kemampuan database dan layanan pendukung. Aturan yang keliru dapat membuat kapasitas bertambah terlambat, naik-turun secara berulang, atau justru memperbesar tekanan pada komponen yang sudah menjadi bottleneck.
Karena itu, autoscaling perlu dirancang berdasarkan karakteristik beban kerja dan sasaran layanan, bukan hanya berdasarkan satu angka penggunaan CPU. Artikel ini membahas cara memilih metrik, menyusun kebijakan scaling, mengatur cooldown atau jendela stabilisasi, memperhitungkan biaya, dan menguji perilaku sistem sebelum kebijakan digunakan pada lingkungan produksi.
Memahami scale-out, scale-in, dan jenis scaling
Secara umum, autoscaling melakukan dua tindakan utama. Scale-out menambah jumlah instance atau kapasitas ketika sistem membutuhkan lebih banyak sumber daya. Scale-in mengurangi kapasitas ketika beban sudah menurun dan sebagian instance tidak lagi dibutuhkan. Keduanya harus dirancang dengan hati-hati karena keputusan menambah kapasitas biasanya berorientasi pada perlindungan kinerja, sedangkan pengurangan kapasitas juga harus mempertimbangkan keamanan proses, sesi pengguna, dan pekerjaan yang belum selesai.
Autoscaling horizontal menambah atau mengurangi jumlah instance, misalnya menambah replika aplikasi dari dua menjadi empat. Autoscaling vertikal mengubah ukuran sumber daya suatu instance, seperti menambah CPU atau memori. Scaling horizontal sering digunakan pada layanan yang dapat berjalan dalam beberapa replika, sedangkan scaling vertikal dapat lebih mudah diterapkan pada aplikasi yang belum dirancang untuk berjalan secara paralel. Namun, peningkatan ukuran instance memiliki batas atas dan mungkin memerlukan restart atau downtime, tergantung platform.
Selain scaling berdasarkan metrik, terdapat pendekatan terjadwal dan prediktif. Scheduled scaling dapat menaikkan kapasitas sebelum jam sibuk yang berulang, misalnya sebelum periode transaksi harian. Predictive scaling mencoba memperkirakan kebutuhan berdasarkan pola historis dan karakteristik permintaan. Pendekatan prediktif tidak selalu tepat untuk kejadian mendadak, sehingga sering kali tetap perlu dikombinasikan dengan aturan reaktif untuk menghadapi perubahan aktual.
Pilih metrik yang benar-benar mewakili beban
CPU dan memori adalah metrik yang mudah dipahami, tetapi tidak selalu menggambarkan kemampuan aplikasi menyelesaikan pekerjaan. Layanan yang menunggu respons API eksternal dapat menunjukkan penggunaan CPU rendah meskipun antrean permintaan terus bertambah. Sebaliknya, proses komputasi tertentu mungkin menggunakan CPU tinggi secara normal tanpa menyebabkan penurunan pengalaman pengguna.
Metrik sebaiknya dipilih berdasarkan hubungan langsung dengan beban dan sasaran layanan. Beberapa pilihan yang dapat dipertimbangkan antara lain:
- CPU utilization: berguna untuk aplikasi yang intensif komputasi dan memiliki hubungan cukup jelas antara penggunaan CPU dengan kemampuan memproses permintaan.
- Memory utilization: membantu mengidentifikasi tekanan memori, risiko swapping, atau kebutuhan kapasitas yang meningkat, tetapi perlu dibedakan antara penggunaan memori yang wajar dan kebocoran memori.
- Request rate per instance: memperkirakan jumlah permintaan yang ditangani setiap replika. Metrik ini lebih informatif dibanding total request ketika jumlah instance berubah.
- Queue depth atau backlog: menunjukkan pekerjaan yang masih menunggu diproses, sangat berguna untuk worker, sistem antrean, dan pemrosesan latar belakang.
- Request latency: latensi p95 atau p99 dapat mengungkap penurunan layanan yang tidak terlihat dari rata-rata, tetapi perlu dianalisis bersama penyebab dan volume permintaan.
- Concurrency atau jumlah koneksi aktif: dapat membantu untuk aplikasi yang dibatasi oleh jumlah worker, koneksi, atau kapasitas penanganan sesi bersamaan.
- Throughput pekerjaan: mengukur jumlah tugas yang benar-benar selesai dalam periode tertentu, sehingga tim dapat melihat apakah kapasitas tambahan meningkatkan hasil.
Contohnya, worker yang memproses antrean dapat memiliki CPU sedang tetapi backlog terus bertambah karena pekerjaan menunggu sistem lain. Dalam kondisi tersebut, jumlah pesan tertunda atau usia pesan tertua mungkin lebih berguna untuk menentukan kebutuhan replika. Untuk API web, request per instance dan latensi p95 dapat memberi gambaran yang lebih dekat dengan pengalaman pengguna.
Jangan menggunakan latensi sebagai satu-satunya pemicu tanpa memahami penyebabnya. Latensi dapat meningkat akibat database lambat, jaringan bermasalah, atau API pihak ketiga yang sedang terganggu. Menambah instance aplikasi pada kondisi tersebut mungkin hanya meningkatkan jumlah koneksi ke backend yang sudah kewalahan. Gabungkan metrik aplikasi dengan metrik komponen pendukung agar tindakan scaling tidak salah sasaran.
Hubungkan metrik dengan kapasitas layanan
Target scaling perlu menggambarkan tingkat beban yang dapat ditangani setiap instance secara aman. Sebagai contoh, jika satu replika secara konsisten mampu menangani sejumlah permintaan per detik sambil menjaga latensi dalam sasaran, jumlah replika dapat disesuaikan agar beban rata-rata per replika tidak melewati kapasitas tersebut. Angka target harus diperoleh melalui pengujian beban dan pengamatan produksi, bukan ditentukan hanya berdasarkan perkiraan.
Gunakan pengukuran yang konsisten. Pastikan metrik memiliki label layanan, lingkungan, dan instance yang benar, serta tidak mencampur trafik pengujian dengan produksi. Jika metrik terlambat dikirim atau memiliki interval pengumpulan yang terlalu jarang, autoscaling dapat mengambil keputusan berdasarkan kondisi yang sudah berubah.
Perhatikan pula periode evaluasi dan agregasi. Rata-rata yang terlalu panjang dapat menyamarkan lonjakan singkat, sedangkan data yang terlalu sensitif dapat memicu perubahan kapasitas karena noise. Persentil, moving average, atau jendela evaluasi tertentu dapat membantu, asalkan dipilih sesuai karakteristik aplikasi dan didukung oleh platform.
Tentukan kapasitas minimum, maksimum, dan kapasitas dasar
Kapasitas minimum menentukan jumlah instance yang tetap tersedia meskipun permintaan sedang rendah. Nilai ini dapat melindungi waktu respons saat trafik kembali naik, menjaga redundansi, atau mempertahankan komponen yang memerlukan ketersediaan terus-menerus. Menetapkan minimum terlalu rendah dapat membuat sistem harus menunggu instance baru saat lonjakan datang, sedangkan minimum terlalu tinggi dapat memboroskan biaya.
Kapasitas maksimum berfungsi sebagai batas pengaman. Batas ini dapat mencegah lonjakan permintaan atau kesalahan metrik menciptakan jumlah instance yang tidak terkendali. Nilai maksimum perlu disesuaikan dengan anggaran, kuota penyedia cloud, batas jaringan, kapasitas database, dan kemampuan layanan downstream. Jika maksimum tercapai, tim harus mengetahui bagaimana sistem akan merespons: apakah permintaan akan ditolak, diantrekan, mengalami throttling, atau menunggu kapasitas tersedia.
Untuk layanan dengan waktu startup panjang atau pola beban yang dapat diprediksi, kapasitas dasar yang memadai sering lebih aman dibanding menunggu autoscaling bereaksi setelah trafik meningkat. Kapasitas dasar bukan berarti menjalankan sumber daya berlebihan, melainkan menyediakan tingkat kesiapan minimum yang sesuai dengan target kinerja dan ketersediaan.
Atur cooldown dan jendela stabilisasi dengan tepat
Cooldown adalah periode atau mekanisme penundaan yang membantu mencegah kebijakan scaling mengambil tindakan berulang terlalu cepat setelah perubahan kapasitas. Beberapa platform memakai istilah stabilization window, warm-up period, atau mekanisme evaluasi serupa. Implementasi dan perilakunya berbeda antarpenyedia, sehingga definisi yang digunakan pada platform harus diperiksa sebelum menetapkan nilai.
Jika cooldown terlalu singkat, sistem dapat menambah instance berkali-kali berdasarkan metrik yang belum mencerminkan dampak kapasitas baru. Hal ini dapat menyebabkan flapping, yaitu kondisi ketika kapasitas naik dan turun secara berulang dalam waktu singkat. Sebaliknya, cooldown terlalu panjang dapat menunda scale-out saat trafik terus bertambah atau membuat kapasitas berlebih bertahan terlalu lama setelah permintaan turun.
Scale-out dan scale-in tidak harus menggunakan waktu stabilisasi yang sama. Menambah kapasitas biasanya perlu dilakukan cukup cepat ketika beban meningkat. Mengurangi kapasitas dapat dibuat lebih konservatif agar lonjakan singkat tidak menyebabkan instance dilepas terlalu dini. Gunakan ambang yang berbeda atau hysteresis bila platform mendukungnya, sehingga kondisi untuk scale-in tidak sama persis dengan kondisi scale-out.
Nilai waktu stabilisasi perlu mengikuti perilaku aplikasi. Perhatikan waktu provisioning, pengambilan image, konfigurasi, pemanasan cache, pembukaan koneksi, dan kesiapan health check. Instance yang sudah tercatat berjalan belum tentu sudah siap menerima trafik. Ukur waktu dari permintaan scaling hingga instance benar-benar sehat dan melayani permintaan dengan normal.
Perhitungkan waktu startup dan kesiapan instance
Autoscaling reaktif memiliki keterbatasan waktu. Metrik harus dikumpulkan, aturan dievaluasi, kapasitas diminta ke penyedia cloud, instance dibuat, aplikasi dijalankan, lalu health check harus menyatakan instance siap. Seluruh tahap ini membutuhkan waktu. Jika lonjakan datang lebih cepat daripada proses tersebut, pengguna tetap dapat mengalami latensi tinggi sebelum kapasitas tambahan tersedia.
Untuk aplikasi yang menggunakan container, waktu penarikan image, ukuran image, proses inisialisasi, dan kesiapan dependensi dapat memengaruhi kecepatan penambahan replika. Untuk VM, proses boot sistem operasi, konfigurasi, pemasangan paket, dan registrasi layanan dapat memperpanjang waktu. Memilih teknologi deployment dan mengoptimalkan proses startup dapat membantu mengurangi jeda tersebut.
Artikel VM vs Container: Memilih Lingkungan Deployment untuk Aplikasi Kecil membahas perbedaan karakteristik VM dan container yang juga berpengaruh pada proses provisioning serta deployment. Sementara itu, Panduan Praktis Menggunakan Cloud-init untuk Otomatisasi Konfigurasi Server menjelaskan bagaimana konfigurasi awal VM dapat dibuat lebih konsisten.
Beberapa teknik yang dapat dipertimbangkan adalah menjaga kapasitas minimum, menggunakan image yang sudah dipersiapkan, mengurangi pekerjaan inisialisasi yang tidak perlu, dan memanfaatkan scheduled scaling sebelum periode sibuk. Untuk aplikasi dengan pola lonjakan yang sulit diprediksi, kombinasi kapasitas dasar dan scaling reaktif biasanya lebih realistis daripada mengandalkan satu mekanisme saja.
Pastikan database dan layanan downstream mampu mengikuti
Menambah instance aplikasi tidak berarti seluruh sistem memperoleh kapasitas tambahan secara otomatis. Setiap instance baru mungkin membuka koneksi database, memanggil API eksternal, membaca cache, atau mengirim pesan ke antrean. Jika komponen tersebut memiliki batas koneksi atau kuota, scale-out dapat memindahkan bottleneck dari lapisan aplikasi ke backend.
Sebagai contoh, menggandakan jumlah replika API dapat menggandakan jumlah koneksi database yang dibuka jika connection pool tidak dibatasi. Database yang sebelumnya stabil dapat mengalami kehabisan koneksi atau peningkatan waktu antre. Hal serupa dapat terjadi pada API pihak ketiga yang memiliki rate limit. Karena itu, kapasitas downstream harus dihitung sebagai bagian dari perencanaan scaling.
Gunakan connection pooling, batas concurrency, cache yang sesuai, antrean untuk pekerjaan yang dapat ditunda, dan circuit breaker bila arsitektur memerlukannya. Pastikan juga aplikasi dapat menangani kegagalan sementara tanpa melakukan retry secara agresif. Retry yang tidak terkendali dapat memperparah beban ketika backend sudah berada dalam kondisi tertekan.
Untuk layanan web dengan beberapa replika, load balancer dan health check membantu mendistribusikan permintaan hanya ke instance yang siap. Baca Panduan Menggunakan Cloud Load Balancer untuk Mendistribusikan Trafik Web untuk memahami peran pemeriksaan kesehatan dan distribusi trafik dalam arsitektur seperti ini.
Perhatikan sesi pengguna dan pekerjaan yang sedang berjalan
Scale-in memiliki risiko operasional yang sering luput dari perhatian. Instance yang akan dihentikan mungkin masih menangani permintaan aktif, menjalankan transaksi, atau memproses pekerjaan latar belakang. Jika instance dihentikan tanpa prosedur yang benar, pengguna dapat menerima error dan pekerjaan dapat gagal atau terduplikasi.
Gunakan mekanisme graceful shutdown dan connection draining apabila tersedia. Instance dapat berhenti menerima permintaan baru terlebih dahulu, menyelesaikan pekerjaan yang sedang berjalan, lalu dihentikan setelah periode yang ditentukan. Untuk worker, gunakan mekanisme acknowledgement dan retry yang aman agar pekerjaan yang terputus dapat diproses kembali tanpa menghasilkan efek samping ganda.
Aplikasi yang menyimpan sesi pengguna secara lokal juga perlu diperiksa. Jika sesi hanya tersimpan di memori satu instance, permintaan pengguna berikutnya mungkin diarahkan ke replika lain dan kehilangan konteks. Pertimbangkan penyimpanan sesi bersama atau desain autentikasi yang sesuai, serta jangan mengandalkan sticky session sebagai solusi untuk semua jenis masalah.
Pilih pola scaling sesuai karakteristik aplikasi
Berbagai pola scaling dapat digunakan sesuai kebutuhan. Target tracking berusaha menjaga metrik pada nilai target, misalnya mempertahankan penggunaan CPU rata-rata atau jumlah permintaan per instance pada tingkat yang telah ditentukan. Pendekatan ini relatif mudah digunakan ketika metrik memiliki hubungan yang jelas dengan kapasitas.
Step scaling menambah atau mengurangi kapasitas berdasarkan seberapa jauh metrik melewati ambang. Misalnya, pelanggaran kecil dapat memicu penambahan satu instance, sedangkan lonjakan besar dapat memicu penambahan beberapa instance. Besarnya langkah harus diuji agar tidak terlalu agresif atau terlalu lambat.
Scheduled scaling sesuai untuk pola yang dapat diperkirakan, seperti jam operasional atau jadwal pemrosesan rutin. Predictive scaling dapat membantu ketika pola historis cukup konsisten dan platform memiliki dukungan prediksi. Sementara itu, sistem berbasis antrean sering lebih cocok menyesuaikan jumlah worker berdasarkan backlog, umur pesan, atau target waktu penyelesaian.
Hindari mengaktifkan terlalu banyak kebijakan yang saling bertentangan tanpa memahami prioritas evaluasinya. Beberapa aturan dapat meminta scale-out sementara aturan lain meminta scale-in. Periksa bagaimana platform menggabungkan beberapa sinyal, bagaimana batas maksimum diterapkan, dan bagaimana keputusan akhir dicatat untuk audit.
Rancang biaya sebagai bagian dari kebijakan scaling
Autoscaling dapat menurunkan biaya ketika kapasitas dikurangi saat beban rendah, tetapi juga dapat meningkatkan biaya dengan cepat ketika trafik meningkat atau kebijakan salah konfigurasi. Karena itu, kapasitas maksimum perlu dipadukan dengan anggaran, kuota, dan alarm. Jangan hanya memantau jumlah instance; hitung pula biaya per permintaan berhasil atau biaya per pekerjaan selesai jika metrik tersebut relevan.
Biaya juga dapat muncul dari komponen pendukung. Setiap instance tambahan mungkin meningkatkan penggunaan storage, transfer data, alamat IP, log, monitoring, koneksi database, atau layanan berbayar lain. Beberapa penyedia menerapkan biaya minimum, biaya lisensi, atau biaya transfer yang tidak selalu terlihat ketika hanya menghitung harga CPU dan memori.
Tentukan ambang pengeluaran yang memerlukan pemeriksaan, notifikasi ketika kapasitas mendekati maksimum, dan prosedur ketika scaling berlangsung tidak biasa. Pengurangan kapasitas secara paksa untuk menekan tagihan juga harus menghindari dampak yang lebih mahal, seperti kegagalan transaksi atau hilangnya pekerjaan. Kebijakan biaya harus diseimbangkan dengan sasaran layanan dan konsekuensi bisnis.
Infrastructure as code dapat membantu menjaga konfigurasi scaling tetap dapat ditinjau dan dilacak. Dengan pendekatan deklaratif, nilai minimum, maksimum, metrik, dan jadwal dapat dikelola bersama konfigurasi infrastruktur lainnya. Artikel Mengelola Infrastruktur Cloud dengan Terraform membahas bagaimana perubahan infrastruktur dapat dibuat lebih konsisten dan mudah diaudit.
Monitoring, observability, dan alarm yang berguna
Autoscaling perlu dipantau sebagai sistem tersendiri. Catat kapan kebijakan meminta perubahan kapasitas, metrik apa yang memicu tindakan, berapa lama provisioning berlangsung, kapan instance dinyatakan sehat, dan apakah perubahan tersebut memperbaiki kondisi aplikasi. Tanpa informasi ini, tim sulit mengetahui apakah scaling benar-benar membantu atau hanya menambah sumber daya.
Dashboard sebaiknya menggabungkan metrik jumlah instance, pemakaian CPU dan memori, request rate, latensi p95 atau p99, error rate, queue depth, koneksi database, dan biaya. Gunakan korelasi waktu agar perubahan kapasitas dapat dibandingkan dengan kondisi layanan. Alarm yang baik memberi sinyal ketika sistem mendekati batas, bukan hanya setelah layanan gagal.
Periksa juga kasus ketika autoscaling tidak dapat menambah kapasitas karena kuota tercapai, kapasitas regional tidak tersedia, image gagal diambil, konfigurasi tidak valid, atau health check terus gagal. Kondisi tersebut harus terlihat dalam log dan notifikasi. Rencana cadangan mungkin mencakup pengalihan trafik, pembatasan permintaan, atau pengurangan fitur non-esensial sesuai desain layanan.
Uji kebijakan sebelum diterapkan secara luas
Pengujian autoscaling sebaiknya dilakukan pada lingkungan yang aman dan menyerupai produksi. Buat skenario beban normal, lonjakan mendadak, kenaikan bertahap, penurunan trafik, backlog antrean, kegagalan instance, dan keterbatasan backend. Ukur bukan hanya apakah jumlah instance berubah, tetapi juga apakah latensi, error rate, dan throughput memenuhi sasaran.
Uji scale-out dan scale-in secara terpisah. Pastikan replika baru tidak menerima trafik sebelum siap, dan pastikan instance yang dilepas dapat berhenti tanpa memutus pekerjaan penting. Lakukan pengujian ketika metrik berfluktuasi di sekitar ambang untuk melihat apakah sistem mengalami flapping. Catat waktu reaksi dan bandingkan dengan kebutuhan layanan.
Jika memungkinkan, terapkan perubahan secara bertahap. Mulai dengan batas yang konservatif, amati hasilnya, lalu sesuaikan berdasarkan data. Simpan konfigurasi sebelumnya sehingga tim dapat melakukan rollback apabila kebijakan baru menghasilkan lonjakan biaya atau menurunkan keandalan. Hindari menguji skenario ekstrem langsung pada layanan produksi tanpa rencana mitigasi dan persetujuan operasional yang sesuai.
Hubungan autoscaling dengan cache dan arsitektur layanan
Autoscaling bukan satu-satunya cara untuk menangani lonjakan permintaan. Cache dapat mengurangi pekerjaan yang harus dilakukan aplikasi dan backend, sedangkan CDN dapat melayani aset atau respons yang layak di-cache dari lokasi tepi. Dengan demikian, scaling dan caching sebaiknya dirancang sebagai strategi yang saling melengkapi.
Cache yang kedaluwarsa atau dihapus secara bersamaan dapat memicu lonjakan permintaan ke origin. Jika autoscaling merespons keadaan tersebut tanpa memahami penyebabnya, jumlah instance aplikasi mungkin meningkat sementara database atau origin tetap menjadi titik lemah. Artikel Cache CDN dan Cache Purging: Memperbarui Konten tanpa Beban Berlebih membahas cara mengurangi lonjakan ke origin ketika cache diperbarui.
Pada tingkat lebih luas, pilihan arsitektur menentukan bagian mana yang dapat diskalakan secara independen. Aplikasi monolitik, layanan terpisah, worker, database, dan cache memiliki karakteristik kapasitas yang berbeda. Artikel Panduan Memilih Arsitektur Cloud untuk Infrastruktur Web Modern dapat membantu menempatkan autoscaling sebagai bagian dari rancangan infrastruktur, bukan fitur yang berdiri sendiri.
Checklist penerapan autoscaling cloud
- Tentukan sasaran layanan, seperti batas latensi, error rate, dan kapasitas pemrosesan.
- Pilih metrik yang berkaitan langsung dengan beban nyata dan kemampuan aplikasi menyelesaikan pekerjaan.
- Tetapkan kapasitas minimum, maksimum, dan kapasitas dasar berdasarkan kebutuhan serta anggaran.
- Ukur waktu provisioning dan pastikan instance sehat sebelum menerima trafik.
- Atur kebijakan scale-out dan scale-in secara terpisah, termasuk cooldown atau jendela stabilisasi.
- Pastikan database, cache, antrean, API eksternal, dan kuota layanan pendukung mampu mengikuti pertumbuhan instance.
- Gunakan graceful shutdown, connection draining, dan mekanisme pekerjaan ulang yang aman.
- Pasang monitoring untuk metrik aplikasi, infrastruktur, keputusan scaling, dan biaya.
- Uji lonjakan, penurunan, flapping, kegagalan instance, serta batas kuota sebelum penerapan luas.
- Dokumentasikan perubahan konfigurasi, hasil pengujian, dan prosedur rollback.
Kesimpulan
Autoscaling cloud efektif ketika keputusan perubahan kapasitas didasarkan pada metrik yang benar-benar mewakili beban, bukan sekadar angka yang mudah dikumpulkan. CPU dan memori tetap berguna, tetapi request per instance, antrean, latensi, concurrency, dan throughput dapat memberi gambaran yang lebih sesuai untuk jenis aplikasi tertentu.
Kebijakan scaling juga harus memperhitungkan waktu startup, kapasitas minimum dan maksimum, cooldown, kesiapan instance, serta batas database dan layanan downstream. Scale-out yang cepat tidak akan menyelesaikan masalah jika backend sudah kelebihan beban, sementara scale-in yang agresif dapat memutus sesi atau pekerjaan yang belum selesai.
Rancang autoscaling sebagai bagian dari pengelolaan layanan secara menyeluruh. Gunakan batas biaya dan kuota sebagai pengaman, pantau dampaknya terhadap pengalaman pengguna, serta lakukan pengujian sebelum mengubah kapasitas produksi. Mulailah dengan aturan sederhana yang dapat dijelaskan dan diukur, kemudian tingkatkan kompleksitas hanya ketika data operasional menunjukkan kebutuhan yang nyata.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba