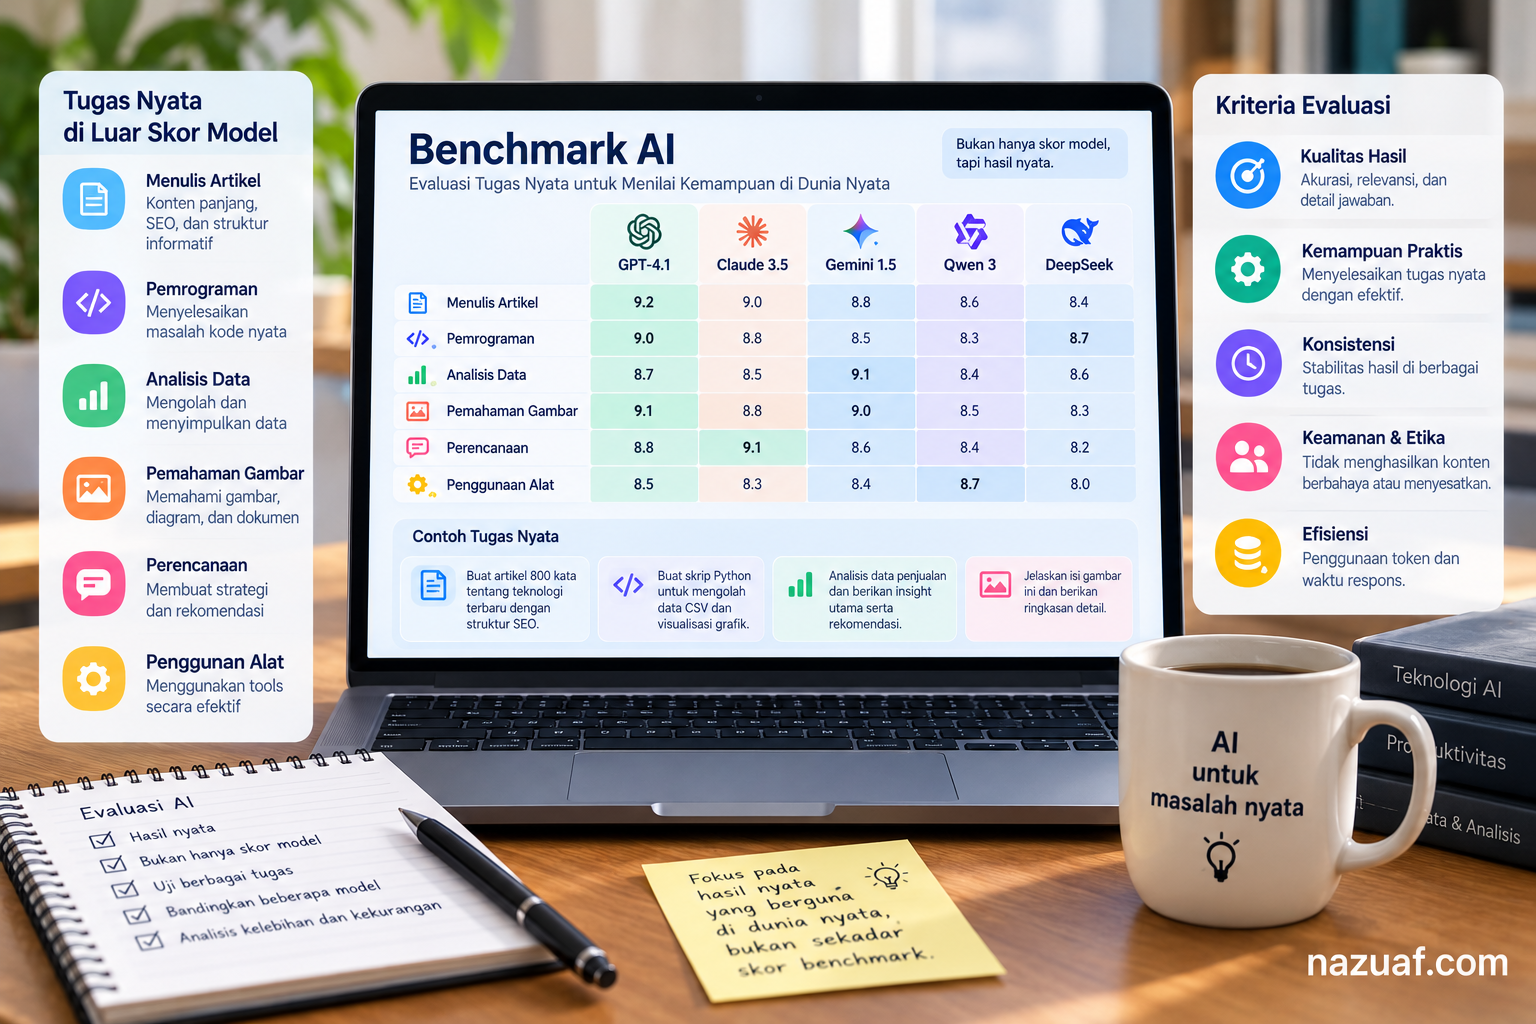
Memilih model kecerdasan buatan hanya dari satu skor benchmark sering menghasilkan keputusan yang keliru. Model dengan nilai tinggi pada tes umum belum tentu paling tepat untuk merangkum dokumen berbahasa Indonesia, mengekstrak data dari formulir, atau menjawab pertanyaan berdasarkan pengetahuan internal. Benchmark AI yang baik menguji pekerjaan yang benar-benar akan dilakukan sistem, bukan sekadar angka yang mudah dibandingkan.
Mulai dari tugas, bukan nama model
Daftarkan skenario penggunaan yang konkret: masukan seperti apa yang diterima, keluaran apa yang diharapkan, dan kesalahan apa yang paling merugikan. Untuk asisten dukungan pelanggan, misalnya, ukuran keberhasilan bisa mencakup ketepatan fakta, kepatuhan terhadap kebijakan, kemampuan mengakui ketidakpastian, serta kualitas eskalasi kepada manusia. Pisahkan tugas sederhana dari kasus ambigu agar hasil tidak menutupi kelemahan pada kelompok tertentu.
Bangun dataset uji yang representatif
Ambil contoh dari variasi bahasa, panjang input, format dokumen, dan tingkat kesulitan yang wajar. Hapus atau samarkan data pribadi yang tidak dibutuhkan. Simpan sebagian contoh sebagai holdout set yang tidak digunakan untuk merancang prompt atau menyetel konfigurasi. Jika contoh tes berulang kali dimasukkan ke pengembangan, skor akhirnya menjadi terlalu optimistis karena sistem telah disesuaikan dengan soal.
Buat juga kumpulan kasus tepi: instruksi yang saling bertentangan, informasi tidak lengkap, angka dengan format lokal, dan permintaan yang harus ditolak. Kasus tepi bukan untuk menjebak model secara acak; tujuannya mengungkap situasi yang mungkin benar-benar ditemui saat sistem digunakan.
Nilai hasil dengan rubrik yang dapat diulang
Gunakan metrik sesuai tugas. Ekstraksi data dapat dinilai melalui akurasi per kolom; klasifikasi melalui precision, recall, dan F1; jawaban berbasis dokumen melalui kecocokan terhadap sumber dan kelengkapan bukti. Untuk tulisan terbuka, susun rubrik terukur—misalnya benar, relevan, lengkap, dan tidak mengarang—lalu audit sebagian hasil secara manual. Penilaian oleh model lain dapat membantu memilah hasil, tetapi jangan dianggap sebagai kebenaran mutlak.
Ukur biaya dan konsistensi, bukan hanya akurasi
Catat latensi persentil tinggi, biaya per tugas berhasil, tingkat kegagalan, kebutuhan koreksi manusia, dan variasi hasil saat tes diulang. Model yang sedikit lebih murah belum tentu unggul jika sering memerlukan perbaikan manual. Uji konfigurasi produksi yang sebenarnya, termasuk system prompt, retrieval, batas output, dan mekanisme fallback. Untuk pengelolaan akses serta pemantauan API, Nazuaf juga membahas penggunaan AI Gateway.
Jadikan benchmark sebagai proses berkelanjutan
Simpan versi dataset, rubrik, konfigurasi, tanggal pengujian, serta alasan memilih model. Jalankan ulang benchmark saat model, prompt, sumber data, atau biaya penyedia berubah. Tambahkan contoh kesalahan dari produksi setelah data sensitif dibersihkan. Dengan proses ini, benchmark menjadi alat pengambilan keputusan yang dapat diaudit, bukan klaim pemasaran atau tes satu kali.
Checklist singkat
- Gunakan tugas yang relevan dengan pengguna nyata.
- Pisahkan dataset pengembangan dan pengujian.
- Definisikan rubrik sebelum melihat hasil.
- Ukur mutu, biaya, latensi, dan koreksi manusia.
- Catat versi dan ulangi tes setelah perubahan penting.
Intinya, benchmark AI yang berguna menjawab pertanyaan “model mana yang paling baik untuk pekerjaan ini, dengan batasan ini?”—bukan “model mana yang memiliki angka tertinggi di semua situasi?”.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba