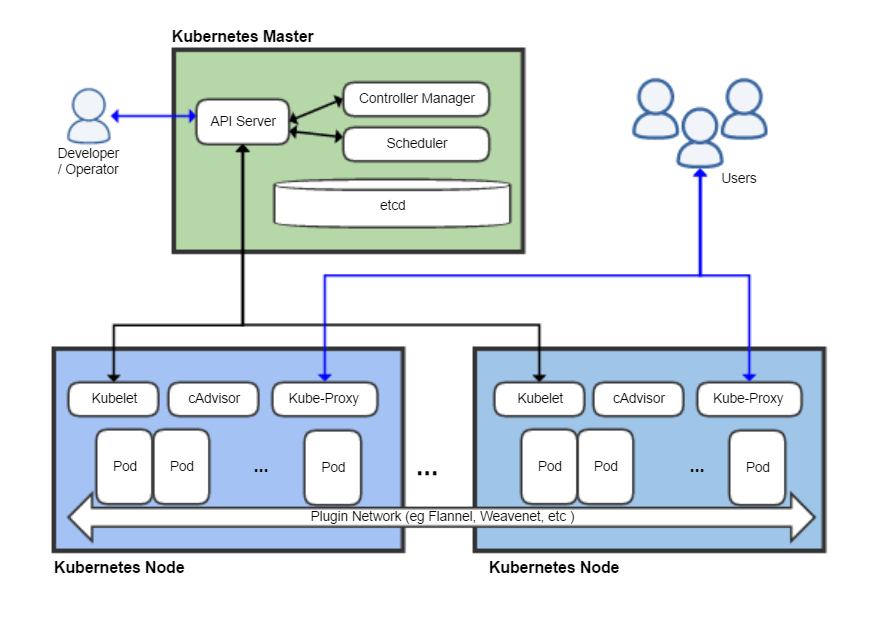
Aplikasi yang berjalan di dalam container belum tentu siap melayani pengguna. Proses bisa hidup tetapi macet, aplikasi mungkin masih memuat konfigurasi, atau layanan perlu menunggu koneksi ke database. Kubernetes menyediakan probes untuk membantu menentukan kondisi tersebut. Dengan konfigurasi yang tepat, platform dapat menghentikan pengiriman trafik ke container yang belum siap dan memulai ulang container yang benar-benar tidak sehat.
Tiga pemeriksaan yang paling sering digunakan adalah liveness, readiness, dan startup probe. Ketiganya terlihat mirip karena sama-sama memeriksa aplikasi, tetapi masing-masing menjawab pertanyaan berbeda. Menyamakan fungsinya justru dapat menyebabkan restart berulang atau layanan tidak tersedia saat proses deployment.
Apa itu probe di Kubernetes?
Probe adalah pemeriksaan berkala yang dilakukan oleh kubelet terhadap container di dalam Pod. Hasilnya membantu Kubernetes mengambil tindakan sesuai tujuan pemeriksaan. Pemeriksaan dapat menggunakan HTTP, koneksi TCP, perintah di dalam container, atau gRPC pada versi Kubernetes yang mendukungnya. Endpoint atau perintah yang diperiksa harus menggambarkan kondisi aplikasi secara akurat, bukan sekadar membuktikan bahwa port terbuka.
1. Liveness probe: apakah aplikasi masih bekerja?
Liveness probe menjawab apakah aplikasi masih dapat membuat kemajuan. Contoh kasusnya adalah proses mengalami deadlock: container masih berjalan dan port mungkin terbuka, tetapi permintaan baru tidak lagi diproses. Jika liveness probe gagal melewati ambang yang ditentukan, kubelet akan memulai ulang container sesuai kebijakan Pod.
Gunakan pemeriksaan ini untuk mendeteksi kondisi yang memang bisa dipulihkan dengan restart. Hindari memeriksa setiap layanan eksternal dari endpoint liveness. Jika database sedang lambat, misalnya, semua replika aplikasi bisa gagal liveness sekaligus dan melakukan restart bersamaan, padahal proses aplikasinya sendiri masih sehat.
2. Readiness probe: apakah aplikasi siap menerima trafik?
Readiness probe menentukan apakah sebuah Pod boleh menerima permintaan melalui Service. Aplikasi bisa hidup dengan normal tetapi belum siap karena masih memuat model, melakukan migrasi yang aman, mengisi cache awal, atau menunggu dependensi wajib tersedia. Ketika readiness gagal, Kubernetes menandai Pod sebagai belum siap dan mengeluarkannya dari endpoint Service yang sesuai. Container tidak otomatis direstart hanya karena readiness gagal.
Probe ini penting saat rolling update dan ketika aplikasi sementara tidak mampu melayani permintaan. Endpoint readiness sebaiknya memeriksa kesiapan yang relevan terhadap trafik. Jangan membuatnya terlalu rumit atau bergantung pada terlalu banyak layanan opsional, karena hasilnya dapat membuat seluruh Pod tidak siap meskipun sebagian fungsi masih bisa digunakan.
3. Startup probe: beri waktu untuk aplikasi memulai
Startup probe dirancang untuk aplikasi yang membutuhkan waktu lama saat mulai berjalan. Selama startup probe belum berhasil, pemeriksaan liveness dan readiness tidak dijalankan. Ini mencegah liveness probe menganggap aplikasi lambat saat boot sebagai proses macet dan membunuhnya sebelum sempat selesai memulai.
Setelah startup probe berhasil, pemeriksaan liveness dan readiness mulai berjalan sesuai konfigurasi. Startup probe bukan pengganti kedua pemeriksaan lainnya; fungsinya melindungi fase awal aplikasi, terutama ketika waktu mulai bisa bervariasi karena ukuran data, inisialisasi runtime, atau pemuatan model.
Contoh konfigurasi HTTP
Contoh berikut menunjukkan satu container dengan endpoint terpisah untuk startup, liveness, dan readiness. Sesuaikan nama endpoint, port, serta durasinya dengan perilaku aplikasi yang sebenarnya.
apiVersion: v1
kind: Pod
metadata:
  name: aplikasi-demo
spec:
  containers:
    - name: aplikasi
      image: example/aplikasi:1.0
      ports:
        - containerPort: 8080
      startupProbe:
        httpGet:
          path: /startup
          port: 8080
        periodSeconds: 5
        failureThreshold: 30
      livenessProbe:
        httpGet:
          path: /healthz
          port: 8080
        periodSeconds: 10
        timeoutSeconds: 2
        failureThreshold: 3
      readinessProbe:
        httpGet:
          path: /ready
          port: 8080
        periodSeconds: 5
        timeoutSeconds: 2
        failureThreshold: 2
Dalam contoh ini, startup probe dapat memberi waktu sekitar 150 detik sebelum dianggap gagal, karena pemeriksaan berjalan setiap lima detik dan ambang kegagalannya 30. Nilai aktual juga dipengaruhi waktu tunggu dan perilaku pemeriksaan. Jika aplikasi belum berhasil melewati startup dalam jangka tersebut, Kubernetes akan menganggap startup gagal dan memulai ulang container.
Endpoint di atas hanyalah contoh. Bila aplikasi belum memiliki endpoint khusus, pemeriksaan TCP dapat memastikan port dapat menerima koneksi, tetapi itu belum tentu membuktikan bahwa aplikasi mampu memproses permintaan dengan benar. Pemeriksaan berbasis perintah juga dapat digunakan ketika ada sinyal kesehatan lokal yang lebih tepat.
Cara memilih nilai probe yang masuk akal
- Ukur waktu mulai nyata. Amati proses startup pada kondisi normal dan saat beban atau penyimpanan melambat. Pilih ambang yang memberi ruang wajar, bukan angka acak.
- Atur timeout dan interval. Timeout terlalu pendek dapat menghasilkan kegagalan palsu; interval terlalu rapat menambah beban pemeriksaan dan log.
- Gunakan endpoint yang murah. Pemeriksaan sebaiknya cepat, stabil, dan tidak melakukan kueri berat atau pekerjaan yang mengubah data.
- Uji skenario kegagalan. Simulasikan aplikasi macet, dependensi terlambat, dan startup lambat pada lingkungan pengujian sebelum menerapkannya ke produksi.
- Periksa dampak bersama. Hindari konfigurasi yang membuat semua replika gagal pada saat yang sama. Readiness, strategi rollout, kapasitas cadangan, dan pengaturan resource perlu dipertimbangkan bersama.
Kesalahan umum yang perlu dihindari
Kesalahan yang sering terjadi adalah menggunakan satu endpoint identik untuk semua probe tanpa memahami konsekuensinya. Endpoint yang mengembalikan gagal setiap kali database sementara tidak tersedia dapat membuat liveness memicu restart yang tidak perlu. Sebaliknya, endpoint yang hanya memeriksa bahwa proses berjalan mungkin selalu sukses meskipun aplikasi sudah macet.
Periksa pula event Pod dan log container ketika probe gagal. Perubahan konfigurasi tidak sebaiknya langsung dilakukan dengan menaikkan semua ambang kegagalan; cari dulu penyebabnya, seperti batas CPU yang terlalu ketat, deadlock, konfigurasi port, atau endpoint kesehatan yang lambat. Panduan resmi Kubernetes tentang liveness, readiness, dan startup probes menjelaskan jenis pemeriksaan serta parameter yang tersedia.
Kesimpulan
Ingat tiga pertanyaan utama: liveness memeriksa apakah aplikasi perlu dimulai ulang, readiness menentukan apakah aplikasi boleh menerima trafik, sedangkan startup memberi waktu bagi aplikasi untuk selesai memulai. Konfigurasi yang tepat membantu Kubernetes memulihkan kegagalan tanpa memperparah gangguan. Untuk memahami konteks container, baca juga panduan Nazuaf tentang perbedaan container dan virtual machine. Setelah itu, uji probe dengan skenario nyata dan pantau hasilnya sebelum mengandalkannya di lingkungan produksi.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba