Organisasi sering ingin memanfaatkan data untuk memahami perilaku pengguna, mengukur tren, atau melatih model kecerdasan buatan (AI). Masalahnya, data yang berguna untuk analisis bisa memuat informasi sensitif. Menghapus nama saja belum tentu cukup: kombinasi atribut lain kadang masih dapat mengarah pada seseorang. Differential privacy menawarkan pendekatan matematis untuk membatasi seberapa besar hasil analisis dapat berubah karena keberadaan satu individu dalam kumpulan data.
Teknik ini bukan tombol ajaib yang membuat semua data otomatis aman. Hasilnya bergantung pada rancangan algoritma, batas kontribusi data, anggaran privasi, dan cara sistem dioperasikan. Dengan memahami komponennya, tim dapat menilai kapan differential privacy sesuai digunakan dan apa yang harus diuji sebelum diterapkan.
Apa itu differential privacy?
Differential privacy (DP) adalah jaminan privasi untuk suatu proses analisis atau algoritma. Secara intuitif, hasil yang mungkin keluar seharusnya tidak berubah terlalu jauh ketika data satu orang ditambahkan atau dihapus dari kumpulan data. Karena keluaran tidak terlalu bergantung pada satu catatan, pihak yang melihat hasilnya menjadi lebih sulit menyimpulkan apakah orang tertentu ikut berkontribusi.
DP biasanya dicapai dengan menambahkan keacakan yang dikendalikan secara matematis pada hasil, atau pada proses pelatihan model. Contohnya, laporan dapat menambahkan noise ke jumlah pengguna yang memenuhi kriteria tertentu. Angka yang dipublikasikan mungkin tidak persis sama dengan hitungan asli, tetapi tetap dapat berguna untuk melihat pola umum.
Perlindungan ini berlaku pada keluaran algoritma yang dirancang sesuai jaminan DP, bukan berarti basis data mentah aman untuk dibuka. Hak akses, enkripsi, retensi, dan keamanan infrastruktur tetap dibutuhkan.
Bagaimana noise dan parameter epsilon bekerja?
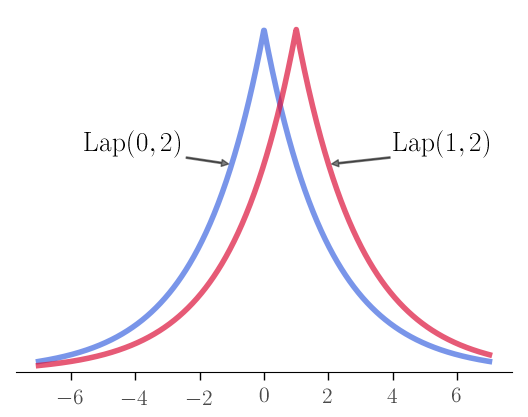
Salah satu mekanisme yang sering dijelaskan adalah mekanisme Laplace: sistem menambahkan noise yang distribusinya dikalibrasi terhadap sensitivitas pertanyaan. Sensitivitas menggambarkan seberapa besar hasil dapat berubah akibat perubahan satu kontribusi individu. Jika setiap orang dapat menyumbang jumlah yang tidak dibatasi, sensitivitas bisa terlalu tinggi; karena itu, sistem biasanya perlu membatasi kontribusi sebelum menghitung keluaran.
Parameter yang sering diperhatikan adalah epsilon (ε), yaitu bagian utama dari anggaran privasi. Secara umum, epsilon yang lebih kecil memberikan jaminan privasi yang lebih kuat, tetapi biasanya membutuhkan lebih banyak noise sehingga hasil kurang presisi. Delta (δ), bila digunakan dalam varian approximate differential privacy, mengizinkan probabilitas kecil di luar batas utama tersebut. Epsilon dan delta bukan skor keamanan universal yang bisa dinilai tanpa konteks.
Contohnya, sebuah layanan ingin merilis jumlah pengguna aktif mingguan. Tim terlebih dahulu menentukan unit privasi—misalnya satu akun—membatasi berapa banyak kontribusi akun yang dihitung, menghitung sensitivitas, lalu memilih mekanisme dan parameter sesuai kebutuhan akurasi serta risiko. Hasilnya harus diuji pada data yang representatif sebelum dipublikasikan.
Central DP dan Local DP
Pada central differential privacy, pengelola memegang data mentah dalam lingkungan yang dipercaya, kemudian menambahkan perlindungan saat menghitung hasil yang dibagikan. Model ini dapat mempertahankan utilitas analitik yang baik, tetapi keamanan penyimpanan dan tata kelola data mentah tetap sangat penting.
Pada local differential privacy, perangkat atau pengguna mengacak data sebelum mengirimkannya ke pengumpul. Pendekatan ini mengurangi kebutuhan mempercayai pengumpul dengan data mentah, tetapi noise yang diperlukan bisa membuat hasil agregat lebih sulit diperkirakan secara akurat, terutama jika jumlah sampel kecil.
Pilihan antara keduanya harus mengikuti model ancaman, jumlah data, kebutuhan analisis, dan pihak yang dapat dipercaya. Tidak ada satu model yang selalu paling tepat untuk semua aplikasi.
Di mana teknik ini berguna?
- Analitik produk: mengukur tren penggunaan fitur tanpa menjadikan kontribusi seorang pengguna terlalu menonjol.
- Statistik publik: menerbitkan ringkasan populasi sambil membatasi informasi yang dapat disimpulkan tentang individu.
- Riset kesehatan: mendukung analisis pola kelompok dengan pengendalian ketat atas data pasien dan keluaran yang dirilis.
- Pelatihan AI: teknik seperti differential privacy stochastic gradient descent (DP-SGD) dapat membatasi pengaruh satu contoh pelatihan terhadap model, dengan konsekuensi pada akurasi dan biaya komputasi.
Dalam aplikasi AI, DP juga perlu dibedakan dari metode lain. Misalnya, vector database untuk AI membantu pencarian informasi berdasarkan kemiripan semantik, tetapi tidak dengan sendirinya memberikan jaminan differential privacy. Begitu pula pemrosesan lokal atau cloud tidak otomatis menentukan apakah sebuah sistem memenuhi DP.
Kesalahan yang perlu dihindari
Menganggap epsilon sebagai label aman atau tidak aman
Nilai epsilon perlu dinilai bersama definisi unit privasi, jumlah rilis, ukuran populasi, jenis analisis, dan dampak jika informasi terungkap. Anggaran privasi yang sama dapat memiliki implikasi berbeda pada konteks yang berbeda. Jangan memilih angka hanya karena umum dipakai produk lain.
Mengabaikan komposisi anggaran
Setiap kueri atau pelatihan yang menggunakan data dapat menghabiskan sebagian anggaran privasi. Banyak rilis berulang dapat memperlemah jaminan kumulatif. Catat setiap penggunaan anggaran dan batasi akses untuk menjalankan kueri, bukan hanya mengamankan satu hasil secara terpisah.
Mencampuradukkan DP dengan anonimisasi atau keamanan sistem
DP tidak mencegah kebocoran karena salah konfigurasi, akses tidak sah ke data mentah, atau pengiriman informasi melalui log. Data yang dibatasi dengan DP juga masih dapat menghasilkan kesimpulan kelompok yang sensitif. Kontrol akses, minimisasi data, pengujian, dan proses respons insiden tetap dibutuhkan.
Checklist sebelum menerapkan differential privacy
- Tetapkan tujuan analisis, siapa yang akan menerima hasil, dan jenis kerugian yang ingin dicegah.
- Tentukan unit privasi dan batas kontribusi tiap individu, termasuk pada data yang berulang atau memiliki banyak catatan.
- Pilih model central atau local, mekanisme noise, serta parameter epsilon dan delta berdasarkan kebutuhan yang terdokumentasi.
- Uji dampak noise terhadap kegunaan hasil; jangan hanya mengukur privasi tanpa memeriksa apakah analisis masih menjawab pertanyaan.
- Kelola anggaran privasi secara kumulatif, catat setiap rilis, dan tinjau ulang perubahan pipeline atau dataset.
- Periksa seluruh sistem: pengumpulan data, penyimpanan, kontrol akses, log, dan proses berbagi hasil.
Untuk evaluasi yang lebih mendalam, baca panduan NIST SP 800-226, Guidelines for Evaluating Differential Privacy Guarantees dan pengantar NIST tentang differential privacy untuk analisis data yang menjaga privasi. Panduan tersebut menekankan bahwa klaim perlindungan harus dievaluasi sebagai satu sistem, bukan hanya dari satu parameter.
Kesimpulan
Differential privacy memberi cara formal untuk membatasi pengaruh data seorang individu terhadap hasil analisis. Teknik ini berguna untuk statistik, analitik produk, riset, dan sebagian proses pelatihan AI, tetapi tetap memerlukan keputusan yang cermat mengenai sensitivitas, noise, epsilon, delta, dan penggunaan anggaran berulang. Mulailah dengan tujuan serta model ancaman yang jelas, ukur trade-off privasi dan akurasi, lalu audit seluruh pipeline. Dengan pendekatan tersebut, DP dapat menjadi lapisan perlindungan yang terukur—bukan pengganti keamanan data secara menyeluruh.
PENGALAMAN BARU Coba tampilan baru Penasaran dengan pengalaman membaca Nazuaf versi modern? Coba tampilan baru yang dirancang agar nyaman dibaca dari ponsel dan pc. Buka versi modern dan lanjutkan membaca artikel ini. Jelajahi tampilan baru Nazuaf versi modern · Ketuk kartu untuk mencoba